AI Engineering Skills Map: Building and Deploying AI Applications
文章目录
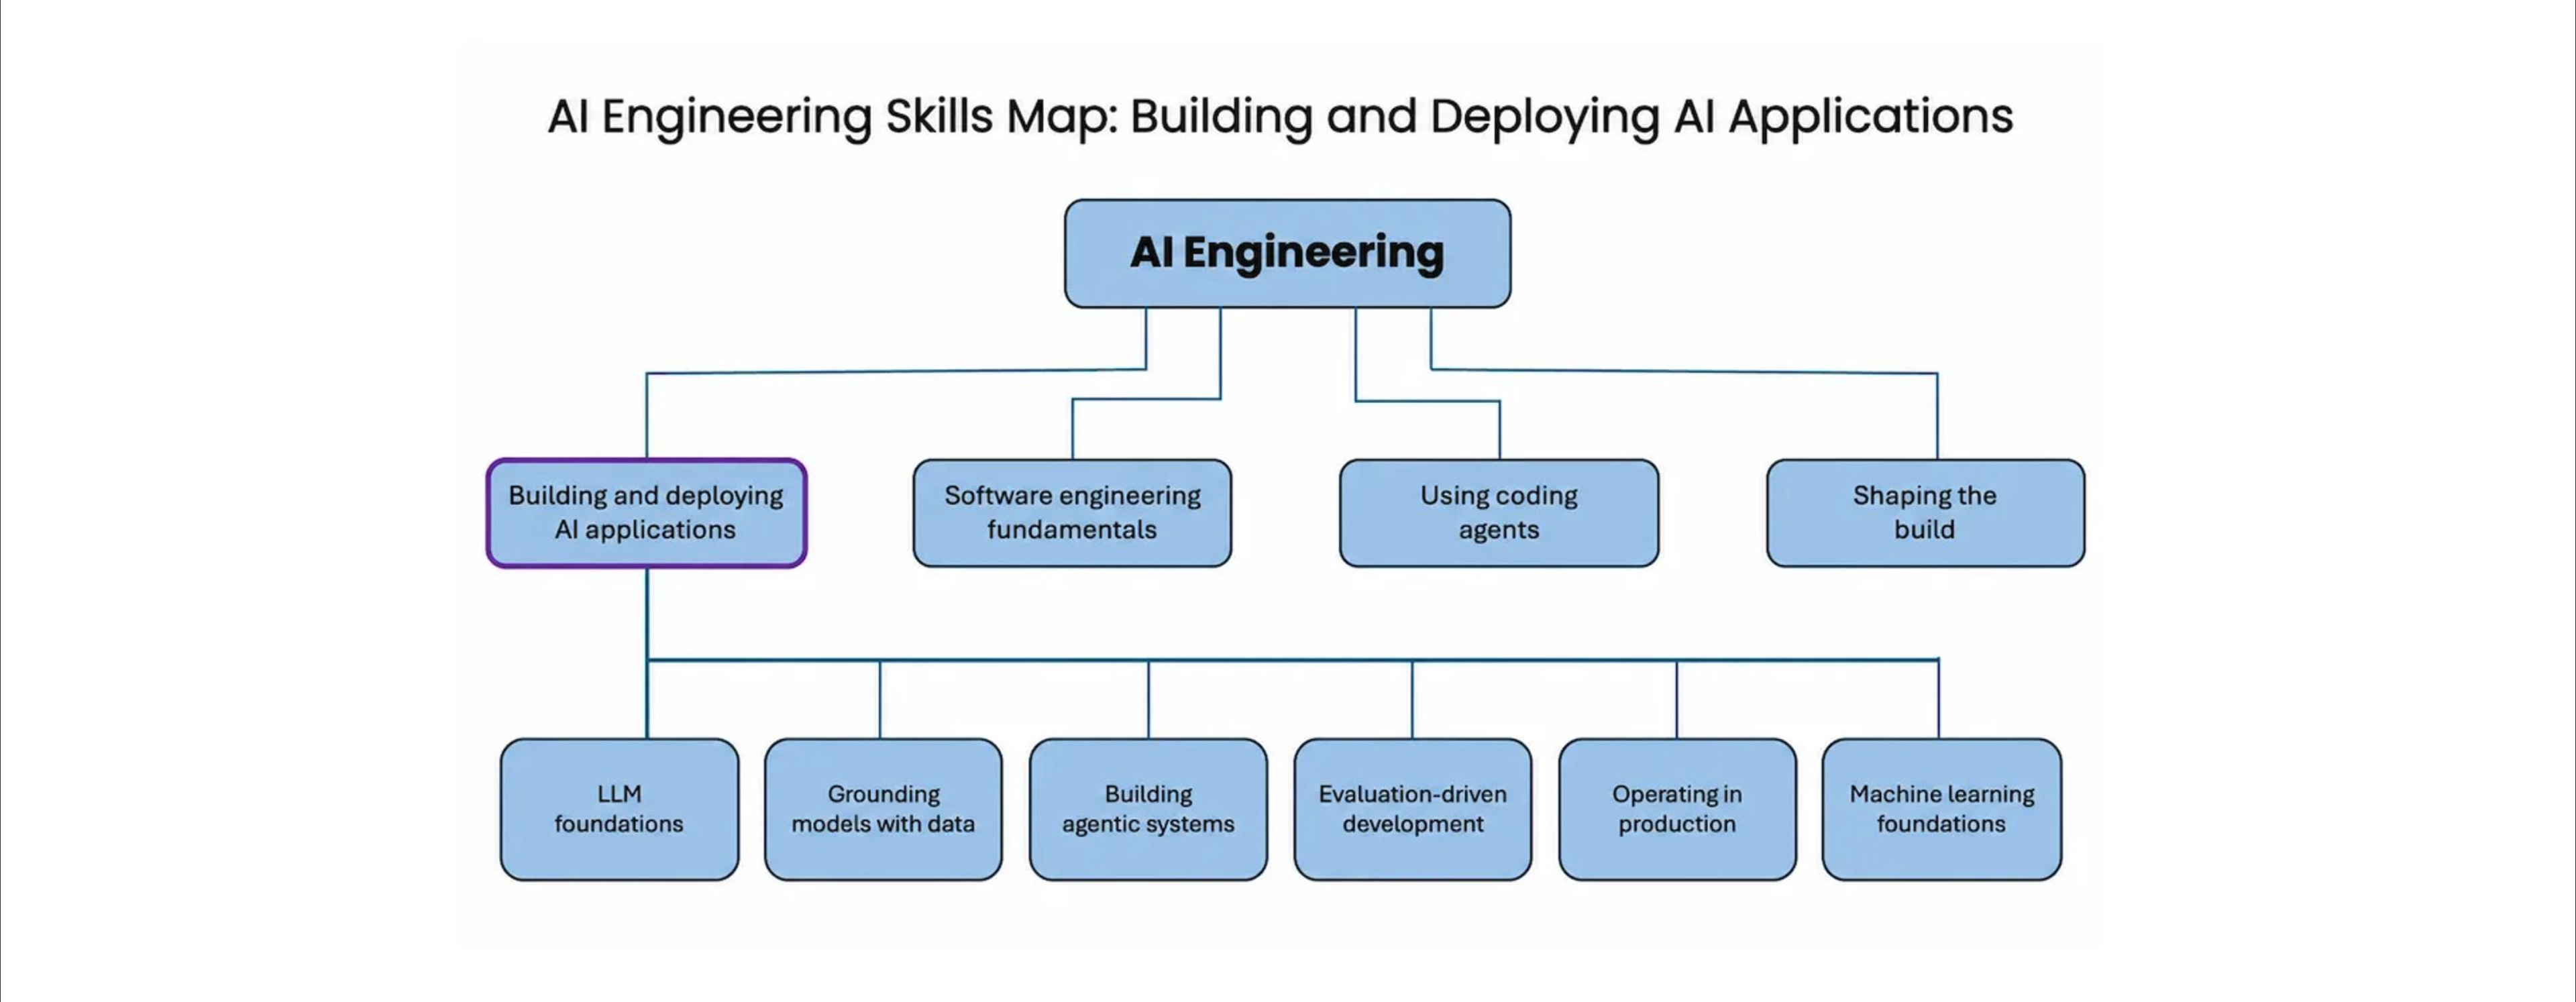
我之前写过《AI Engineering Skills Map》,当时把 AI 工程的四类核心能力概括为:
- 构建与部署 AI 应用
- 软件工程基础
- 使用编程代理(Coding Agents)
- 参与“定义产品”
这篇我先展开第一部分:
要擅长构建与部署 AI 应用,意味着你要掌握:
- LLM 基础
- 用数据对模型进行 grounding
- 构建 Agentic 系统
- 以评估驱动开发
- 在生产环境中稳定运行
- 机器学习基础
这套能力地图是基于大量岗位信息、结构化专家访谈和问卷数据整理出来的。
AI 应用和传统软件的关键差别在于:前者输出更难预测。你不知道 LLM 会输出什么,也无法事先准确预测监督学习模型对新样本会给出什么预测。正因为这种不确定性,构建 AI 系统比传统软件更偏向迭代式工作,前置计划难度更高。优秀的 AI 工程师会反复构建、观察、决策,基于中间结果决定下一步。能够不断判断“下一步该做什么”,才是把不稳定的 AI 组件变成可靠系统的核心。这项能力背后包含多块知识:
1. LLM 基础
理解大语言模型如何分词、如何生成输出,可以帮助你判断它什么时候值得信任、什么时候更可能失效。它还能帮助你决定何时用多模态模型、如何在上下文窗口中做取舍、以及如何理解缓存命中、知识截止时间、推理强度、采样参数,什么时候该用工具调用等能力。
懂这些基础,才能选择合适的模型或模型组合,也能在需要时使用专业手段,比如微调或自部署模型。
2. 用数据给模型“定向”
LLM 需要高质量上下文,才能给出可用结果。RAG 基于向量检索是早期给模型加上下文的手段之一,但可选技术已经扩展得很广。
你会需要判断:哪些信息放进提示词,哪些留给 LLM 通过工具按需检索;数据和查询更适合哪种表示方式:向量索引、知识图谱,还是结构化数据上的语义层(比如客户档案)。
你还要把文档(文本、PDF、HTML、图片)转为 LLM 可读输入,并建立数据清洗与更新流水线。只有当你了解可用技术清单,才能持续为模型提供更相关的上下文。
3. 构建 Agentic 系统
Agentic 系统从固定顺序执行的 LLM 工作流,到模型自主决策下一步的 agent harness 都在你的选择范围内。你需要决定编排方式:哪些步骤串联,哪些并行,什么时候用代码,什么时候让 LLM 决策,并给工作流/架构加上兜底分支。
在设计 agent loop 时,你还要决定模型可调用哪些工具(包括 MCP、CLI、沙箱执行环境)、用什么记忆架构、如何在长会话里管理上下文,以及何时采用多代理协同而不是单代理。
把原型变为生产级系统时,还要关注可靠性、安全性和治理能力;例如护栏设计、对抗输入防护、以及关键风险规避(如数据外泄)。
Agentic 工作流变化很快,你还要了解相关领域的新技术,比如语音代理、计算机操作代理、生成式 UI。
4. 评估驱动开发
我看来,能把 AI 系统做好的关键能力之一是是否能跑出一套有纪律的评估与误差分析闭环。它能持续把团队精力集中到更可能成功的方向。
构建高质量评估本身是技术活。你需要查看系统 trace 与输出,做探索性分析,结合业务视角判断该衡量什么。你还要知道不同评估方式:
- 何时用确定性(代码化)评估
- 何时用 LLM-as-a-judge
- 何时引入人工复核
- 如何持续校准与迭代自己的评估方法
这些评估再反过来指导下一轮开发,让进展更稳定、可复现,而不是靠随机试错。
5. 生产运维
AI 系统在生产中的差异比传统软件更明显:不确定性、成本和时延都更难处理。
你需要能搭建可观测性能力,理解真实流量下的表现,监控漂移,并在模型失效或安全事件(比如对抗式注入)发生时快速响应。
AI 体系还需要更有统计意识的回归测试和 CI/CD,测试强度要按风险等级分层。
另外,你还要能选对成本与时延优化组合,比如模型选择优化、蒸馏与微调,以及把 Agentic 流程做简化。
如果你的产品规模上来,成本与时延优化会直接决定体验和可持续性。
6. 机器学习基础
现代 LLM 依赖监督学习与强化学习。每个在 LLM 方向上做得不错的工程师,通常都能讲清机器学习/深度学习。
很多场景仍然需要自己用别人训练好的模型,或者直接从头训练。那意味着你要熟悉常见机器学习和深度学习模型,以及准确率、训练速度、推理速度等权衡;能正确准备与评估训练数据。
偏差/方差分解、误差分析、数据工程这些概念,在处理“输出不确定”的系统时仍然是核心框架,能指导大量实践决策。
学习这条线需要投入很深的技术训练,但每一步都能显著提升你做 AI 工程的质量。它的强互补是扎实的软件工程能力,我会在后续文章里展开讲。